Kubernetes i produktion: Platform eller byg selv?

Kubernetes drift er i dag en central disciplin for organisationer, der arbejder med containerbaserede applikationer. Kubernetes er i dag den dominerende standard for containerorkestrering. Det er ikke et nichevalg — det er den teknologi, som de fleste organisationer, der arbejder seriøst med containere, ender med at vælge. Og det er forståeligt. Kubernetes er kraftfuldt, fleksibelt og bakket op af et massivt open source-fællesskab.

Men der er en forskel på at bruge Kubernetes og at drive Kubernetes.


Hvorfor Kubernetes er blevet standarden

Kubernetes løser et fundamentalt problem: hvordan deployer, skalerer og styrer man containeriserede applikationer på tværs af mange servere og miljøer? Svaret, som Kubernetes giver, er fleksibelt nok til at dække de fleste use cases — fra en enkelt applikation til en kompleks microservices-arkitektur med hundredvis af tjenester.

Dertil kommer, at Kubernetes platformen er cloud-agnostisk. Det kører på de store cloud-platforme, on-prem og i hybride miljøer. Det er en af grundene til, at teknologien er endt som industristandard.


Hvad der typisk fungerer fint i starten

De fleste virksomheder, der starter med Kubernetes, oplever de første måneder som relativt overkommelige. Et pilotprojekt med én eller to applikationer fungerer, teamet lærer teknologien at kende, og deployments sker stabilt.

På det tidspunkt virker beslutningen om at bygge og drifte Kubernetes selv fornuftig. Man har kontrollen, man forstår opsætningen, og man undgår ekstraomkostningerne ved en kommerciel platform.


Hvad der bliver komplekst i produktion

Det er typisk her, Kubernetes drift for alvor begynder at kræve struktur og specialiserede kompetencer. Udfordringerne opstår, når Kubernetes bevæger sig fra eksperiment til kritisk infrastruktur. Det er her, virksomheder møder en række problemer, som pilotprojektet ikke forberedte dem på:

  • Sikkerhed
    Kubernetes har mange bevægelige dele, og en forkert konfiguration kan skabe alvorlige sårbarheder. RBAC, netværkspolitikker, image-scanning og secrets management er alle discipliner, der kræver løbende opmærksomhed og ekspertise.
  • Opgraderinger
    Kubernetes udgiver nye versioner med korte intervaller, og support på ældre versioner ophører hurtigt. Opgraderinger af produktionsklynger er ikke trivielle — de kræver test, koordination og et klart rollback-scenarie.
  • Cluster management
    At drifte ét cluster er én ting. At drifte flere clusters på tværs af miljøer — udvikling, test, produktion — med konsistent konfiguration og adgangsstyring er en markant mere kompleks opgave.
  • Multicluster drift
    Når organisationen vokser, følger kravene til multicluster management med. Synlighed, governance og ressourcestyring på tværs af clusters er en disciplin for sig.
  • Integration til CI/CD og udviklerworkflows
    Kubernetes skal hænge sammen med pipelines, image-registries, versionsstyring og udviklernes daglige workflow. Det kræver design og vedligeholdelse — og det er sjældent sat ordentligt op fra starten.
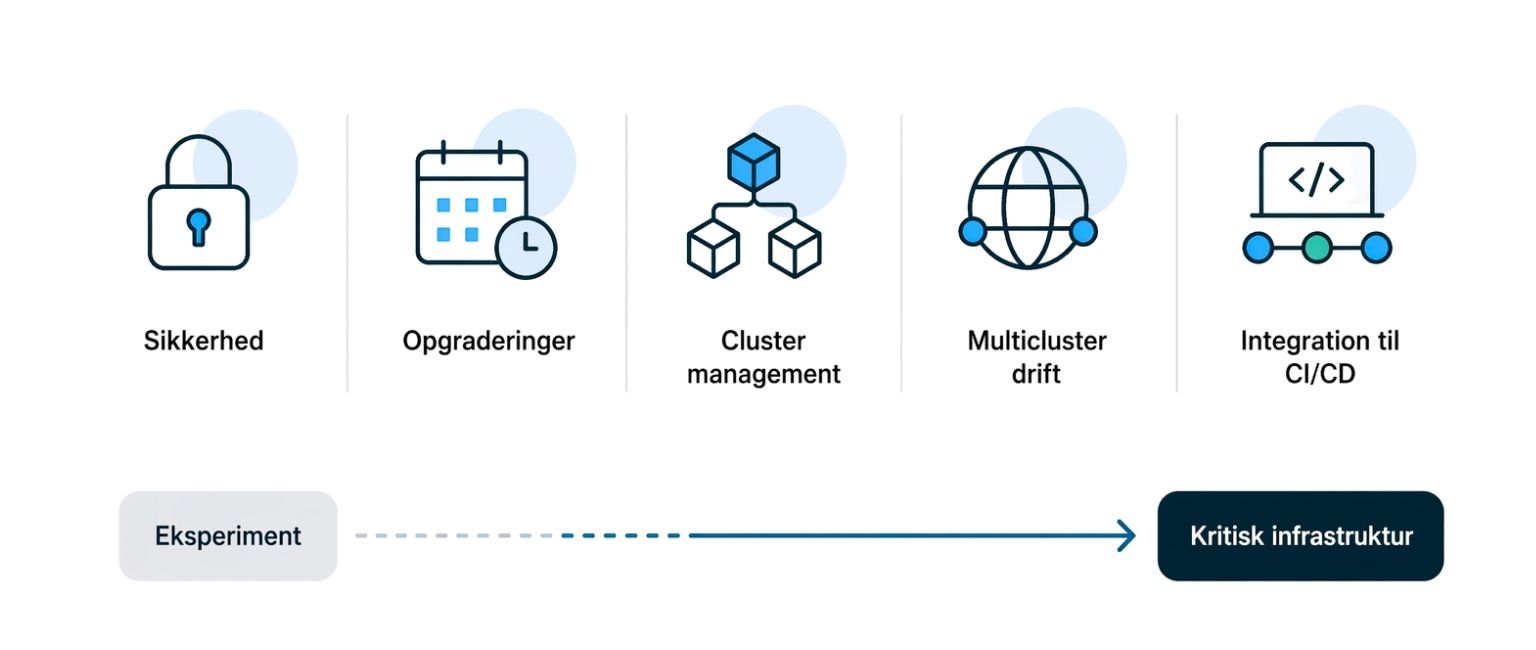
 

Når Kubernetes bliver til drift

Det er typisk i det øjeblik, Kubernetes bevæger sig fra teknologi til drift, at mange organisationer begynder at se på alternativer til den hjemmebyggede tilgang. Ikke fordi Kubernetes er det forkerte valg, men fordi den operationelle byrde overstiger det, it-afdelingen kan absorbere.

Her er Red Hat OpenShift platformen et velafprøvet svar. OpenShift er ikke en erstatning for Kubernetes — det er Kubernetes, baseret på upstream Kubernetes, pakket og udvidet til enterprise-drift.

Platformen indeholder:

  • Integreret sikkerhed med stramme standardindstillinger og løbende sårbarhedsscanning
  • Et managed opgraderingssystem, der håndterer versionsovergange kontrolleret
  • Udviklingsværktøjer og pipeline-integration, der reducerer friktionen i det daglige workflow
  • Enterprise-support og defineret ansvar — i modsætning til at bære hele supportbyrden selv

Det er ikke et spørgsmål om ambition. Det er et spørgsmål om, hvad det koster at drifte selv kontra at bygge oven på en platform, der allerede har løst disse udfordringer.

> Download whitepaper: èn platform til både virtualisering og containerdrift


Hvornår giver det mening at bygge selv?

Det er rimeligt at spørge, om der er situationer, hvor det stadig giver mening at drifte Kubernetes uden en kommerciel platform. Svaret er ja — primært i virksomheder med stærke interne Kubernetes-kompetencer, et dedikeret platform-team og et begrænset antal clusters i et veldefineret miljø.

For de fleste enterprise-virksomheder er det dog ikke den virkelighed, de befinder sig i. De har blandede kompetencer, mange parallelle projekter og et voksende krav om sikkerhed og compliance — og det er præcis her, en platform som OpenShift leverer sin reelle forretningsværdi.


Praktiske erfaringer taler for sig selv

Vi ser det gentage sig: virksomheder starter med et ambitiøst, selvbygget Kubernetes-setup — og tre til tolv måneder inde begynder de at spørge, om der er en smartere vej. Det er ikke et tegn på fejltagelse. Det er et tegn på, at de nu forstår, hvad produktionsdrift af Kubernetes egentlig kræver.

Vi arbejder med virksomheder i begge situationer — dem der overvejer Kubernetes for første gang, og dem der allerede driver det og søger et mere stabilt fundament. Som Red Hat-partner har vi de kompetencer og den erfaring, der skal til for at rådgive om OpenShift og den rette arkitektur til netop jeres workloads.

Mads Andersen, Komplex itKontakt Mads Andersen for en teknisk dialog om jeres Kubernetes drift, hvor jeres platform er i dag — og hvad der skal til for at gøre den produktionsklar på den lange bane, uanset om I arbejder med en Kubernetes platform eller overvejer OpenShift som container platform. Udfyld formularen herunder:

Kun så vi ved, hvem vi skriver til – ingen lister, ingen spam.
Hjælper os med at sætte dit spørgsmål i den rigtige kontekst – og det er dét.
Vi bruger den kun til at svare dig tilbage. Én gang, punktum.
Kun hvis det er nemmere at ringe dig op. Ingen skjulte salgsopkald.
Smid gerne et par stikord, så rammer vi rigtigt fra start.

Patch management er ikke et projekt — det er en driftsopgave: Sådan gøres det med RHEL og Satellite

De fleste it-afdelinger ved godt, at de bør patche mere systematisk. Det er ikke ny viden. Alligevel er reaktiv og ustruktureret patching fortsat normen i mange organisationer — ikke fordi it-chefen er ligeglad, men fordi patching er tidskrævende, forbundet med nedetidsrisiko og ofte nedprioriteret til fordel for opgaver, der opleves som mere presserende.

NIS2-direktivet ændrer den kalkule. Direktivet stiller konkrete krav om systematisk risikostyring og forretningskontinuitet — og patch management er en direkte del af det. En virksomhed, der ikke kan dokumentere sin patchpraksis, opfylder ikke NIS2. Det er ikke en grå zone — det er et krav.

Her forklarer vi, hvad der konkret skal til for at gøre patch management til en driftsdisciplin frem for en brandslukning — med Red Hat Enterprise Linux og Red Hat Satellite som det tekniske fundament.


Problemet med reaktiv patching

Reaktiv patching er ikke en strategi. Det er fravær af en strategi — og det har konkrete konsekvenser.

Konsekvenserne ser typisk sådan ud i praksis:

  • Sikkerhedshuller vokser stille: Kritiske patches udsættes, fordi der ikke er tid eller overblik. Angribere udnytter aktivt kendte, upatchede sårbarheder — og det tager gennemsnitligt 15 dage fra en sårbarhed offentliggøres, til den udnyttes aktivt
  • Frygt for nedetid lammer beslutningen: Mange it-afdelinger undgår patching af produktionssystemer, fordi de ikke har testet patches i et kontrolleret miljø. Resultatet er systemer, der kører forældede versioner måneder — eller år — efter, at kritiske rettelser er tilgængelige
  • Ingen dokumentation — ingen compliance: Kan I ikke bevise, hvornår et system sidst blev patchet og hvilke patches der er rullet ud, har I ikke et NIS2-compliant setup. En audit-log er ikke valgfrit — det er et krav
  • Manuel patching skalerer ikke: Med mange RHEL-servere er manuel patching en tidssluger og en fejlkilde. Jo flere systemer, jo større risiko for inkonsistente konfigurationer og oversete patches

Patching er ikke et projekt, der afsluttes. Det er en løbende driftsproces — og den kræver de rigtige værktøjer.
 

RHEL som det rette fundament

Red Hat Enterprise Linux er enterprise-operativsystemet, der er designet til stabil, sikker og langvarig drift. RHEL-subscriptionen giver adgang til:

  • Sikkerhedsopdateringer og fejl, kategoriseret som kritiske, vigtige, moderate og lave efter CVE-score
  • Udvidet livscyklussupport — RHEL-versioner supporteres i op til 10 år, med mulighed for udvidet support herefter
  • Adgang til Red Hat’s sikkerhedsteam og sårbarhedsdatabase
  • Understøttelse på tværs af fysiske servere, virtuelle maskiner og cloud-miljøer

RHEL er fundamentet — men subscription alene er ikke nok til at gøre patch management til en velfungerende driftsdisciplin. Det kræver Satellite og Ansible.
 

Red Hat Satellite: Centraliseret livscyklusstyring for RHEL

Red Hat Satellite — inkluderet i Red Hat Smart Management — er den platform, der omsætter RHEL-subscription til struktureret og auditbar drift. Satellite giver ét samlet kontrolpunkt for provisionering, patching, konfiguration og compliance på tværs af hele RHEL-serverparken.

De centrale kapabiliteter i Satellite er:

  • Content Views: Definer præcis hvilke patches og pakker, der er godkendt til hvilke miljøer — development, test og produktion. Patches flyttes kontrolleret gennem miljøerne, og produktion opdateres aldrig uden at have passeret test
  • Errata management: Satellite giver et komplet overblik over tilgængelige sikkerhedsrettelser, fejlrettelser og forbedringer — kategoriseret og prioriteret. I kan filtrere på kritiske patches og handle hurtigt, når det er nødvendigt
  • Livscyklusstyring: Styr RHEL-systemernes livscyklus fra provisionering til dekommissionering fra ét interface — med fuld historik
  • Compliance og auditspor: Satellite logger præcis, hvad der er rullet ud hvornår og på hvilke systemer. Det er den dokumentation, der holder ved en NIS2-gennemgang — og som viser tilsynsmyndighederne, at patch management er en planlagt og verificeret proces


Satellite og Ansible i kombination

Satellite styrer indholdet og livscyklussen. Ansible eksekverer ændringerne. Tilsammen giver de en fuldt automatiseret patch-proces, der kan planlægges, verificeres og dokumenteres.

Et typisk automatiseret patch-forløb ser sådan ud:

  • Satellite identificerer tilgængelige patches og kategoriserer dem efter kritikalitet
  • Patches godkendes til et testmiljø via Content Views og valideres automatisk
  • Ansible-playbooks kører patching af produktionssystemerne i planlagte vedligeholdsvinduer
  • Satellite logger resultatet og opdaterer compliance-status — klar til audit

Det er denne kombination, der løfter patch-management fra en ad hoc-opgave til en dokumenteret og reproducerbar driftsdisciplin.
 

NIS2 og patch-management: Hvad direktivet faktisk kræver

NIS2’s artikel 21 stiller krav om tekniske og organisatoriske foranstaltninger til risikostyring — herunder systematisk håndtering af sårbarheder og sikkerhedsopdateringer. Det er ikke en vag henstilling. Det er et konkret krav, der forudsætter:

  • En dokumenteret politik for patch management og sårbarhedshåndtering
  • En verificerbar proces for identifikation, prioritering og udrulning af patches
  • Et auditspor, der kan fremvises ved tilsyn — med datoer, systemer og patchhistorik
  • Evne til at dokumentere, at kritiske patches rulles ud inden for en rimelig tidsramme

RHEL og Satellite giver de tekniske forudsætninger for at opfylde disse krav.


Fire spørgsmål, der er værd at stille jer selv

Patch management lyder ofte simpelt på papiret. I praksis er det her, det typisk begynder at skride:

  1. Har I en patchpolitik, der rent faktisk bliver brugt — og som beskriver hvornår og hvordan patches rulles ud?
  2. Kan I dokumentere, hvad der er blevet patchet (og hvornår) det seneste år?
  3. Har I et sted at teste patches, inden de rammer produktion?
  4. Er processen automatiseret — eller afhænger den af, at nogen husker det?

Hvis I tøver ved et eller flere af svarene, er I ikke alene. Men det er også her, forskellen ligger mellem en proces, der ser fin ud på papiret — og en, der faktisk fungerer i driften.

Og det er typisk den forskel, der bliver synlig, når krav som NIS2 rammer.
 

Hvordan kommer man derhen i praksis?

Når patch management skal fungere i driften — ikke bare på papiret — handler det typisk om at få styr på tre ting: overblik, struktur og automatisering.

I et RHEL-miljø ser vi ofte, at det kræver:

  • Et klart billede af, hvordan der patches i dag — og hvor det halter i forhold til interne krav og fx NIS2
  • En struktur for, hvordan patches styres og rulles ud (fx med lifecycle environments og content views)
  • Automatisering, så det ikke afhænger af enkeltpersoner eller manuelle rutiner
  • Dokumentation, der ikke skal samles i sidste øjeblik, men opstår som en del af processen

Teknologisk bliver det ofte bundet sammen med værktøjer som Red Hat Satellite, Smart Management og Ansible — men værktøjerne løser ikke problemet i sig selv. Det gør måden, de bliver brugt på.

Når det bliver gjort ordentligt, ligner det typisk et forløb som dette:

  • Først et realistisk billede af nuværende praksis (ikke kun det, der står i dokumentationen)
  • Derefter opsætning af en struktur, der passer til miljøet — ikke en standardskabelon
  • Automatisering af patching i faste vinduer
  • Opbygning af dokumentation og auditspor som en naturlig del af driften
  • Og til sidst: en proces, der kan køre videre uden at være afhængig af enkeltpersoner

Patch management bliver sjældent en succes, fordi man vælger det rigtige værktøj. Det gør det, når det bliver en integreret del af driften.
 

Har I styr på, hvordan jeres patch management fungerer i praksis?

Vi tager gerne et kig på jeres nuværende setup og giver en konkret vurdering af, hvor det halter, og hvad der skal til for at få det til at fungere i driften. Ræk ud til Mads Andersen:

Kun så vi ved, hvem vi skriver til – ingen lister, ingen spam.
Hjælper os med at sætte dit spørgsmål i den rigtige kontekst – og det er dét.
Vi bruger den kun til at svare dig tilbage. Én gang, punktum.
Kun hvis det er nemmere at ringe dig op. Ingen skjulte salgsopkald.
Smid gerne et par stikord, så rammer vi rigtigt fra start.


Stop med at patche manuelt – automatisér driften med Ansible

Forrester Research udnævnte i december 2024 Red Hat Ansible Automation Platform som markedsleder inden for Infrastructure Automation Platforms. Det er en ekstern validering, der burde sætte gang i en intern diskussion hos mange it-afdelinger — ikke fordi Ansible er nyt, men fordi de fleste it-afdelinger stadig løser driftsopgaver manuelt, som de kunne have automatiseret for to år siden.

Problemet er sjældent manglende vilje. Det er manglende tid, manglende overskud og en opfattelse af, at automatisering er et DevOps-projekt, der kræver et roadmap, et team og et budget. Det er det ikke. Ansible er et driftsværktøj — og det kan tages i brug fra den opgave, der stjæler mest tid i dag.


Manuel drift udfordingen

De fleste it-afdelinger har en serverpark, der patches ad hoc. Ændringer rulles ud manuelt, ét system ad gangen — og dokumentationen er enten forældet eller ikke-eksisterende. Det fungerer, indtil det ikke gør.

Konsekvenserne er veldokumenterede og konkrete:

  • Nøglepersonafhængighed: Én person ved, hvordan 40 servere er konfigureret. Hvis den person er syg, på ferie eller siger op, ved ingen andre præcis, hvad der er sat op — og hvordan.
  • Menneskelige fejl: Manuel konfiguration introducerer fejl. Jo flere servere, jo større sandsynlighed for, at de ikke er identisk konfigureret — og jo sværere er det at fejlsøge, når noget går galt.
  • Manglende auditspor: Ingen kan dokumentere, hvornår hvad blev ændret. Det er et problem ved interne audits, et compliance-problem og en reel risiko, når der opstår hændelser.
  • Patching-efterslæb: Fordi patching er tidskrævende og forbundet med nedetidsrisiko, udsættes det. Det skaber sikkerhedshuller, der vokser stille og roligt — indtil de udnyttes.

Det er ikke et problem, der løses med mere personale. Det løses med forudsigelig automatisering.


Hvad Ansible faktisk er — og hvad det ikke er

Red Hat Ansible Automation Platform er et automatiseringsværktøj til drift. Det er ikke primært et CI/CD-pipeline-tool, et DevOps-framework eller et containerorkestreringssystem — selv om det kan understøtte alle tre.

Kerneprincippet er enkelt: Playbooks beskriver, hvordan systemer skal se ud — og Ansible sørger for, at de faktisk gør det. Playbooks er skrevet i YAML, de er læsbare for både teknikere og ledere, og de fungerer samtidig som levende dokumentation over jeres infrastruktur.

Ansible er agentløst. Det kræver ingen installation af software på de systemer, der skal styres — og dermed ingen ny infrastruktur, ingen nye afhængigheder og ingen ny sikkerheds-angrebsflade. Det gør Ansible særligt egnet til eksisterende RHEL-miljøer, hvor man vil automatisere drift uden at gøre det til et projekt i sig selv.

Forrester Research’s anerkendelse i december 2024 understreger, at Ansible ikke er et nicheprojekt — det er den platform, markedet konsoliderer sig omkring, fordi den er åben, fleksibel og praktisk at integrere med eksisterende leverandørsoftware.


Tre konkrete startpunkter i jeres drift

Automatisering behøver ikke starte stort. De fleste virksomheder finder hurtigt én opgave, der giver umiddelbar effekt — og derfra bygger det sig selv.

  1. Automatiseret patching af RHEL-servere
    Patching er den mest tidskrævende og fejlbehæftede manuelle driftsopgave i de fleste Linux-miljøer. Med Ansible defineres en patchingprocedure én gang i en playbook — og den køres derefter ens på tværs af alle servere, planlagt og verificeret. Resultatet er færre fejl, kortere vinduer og et auditspor over præcis, hvad der er patchet hvornår.
  2. Ensartet konfiguration på tværs af serverparken
    Ansible sikrer, at alle servere er konfigureret identisk — og at de forbliver det. Konfigurationsdrift, hvor servere gradvist afviger fra hinanden, er en hyppig kilde til fejl og sikkerhedsbrister. Ansible detekterer og korrigerer afvigelser automatisk.
  3. Systemhardening og compliance-checks
    Ansible understøtter automatiseret hardening af RHEL-systemer ud fra kendte compliance-rammer. Det betyder, at sikkerhedskonfiguration ikke er noget, der sættes op én gang og aldrig valideres — det er noget, der verificeres løbende og dokumenteres automatisk.

[BILLEDE: Illustration af automatiseret flow — server → playbook → drift, simpelt diagram]


Ansible starter ikke som et roadmap — det starter som én opgave

En af de hyppigste misforståelser om Ansible er, at man skal have et færdigt automatiseringslandkort, inden man begynder. Det er forkert — og det er også den tilgang, der oftest fører til, at projektet aldrig starter.

Den effektive tilgang er gradvis adoption. Start med den opgave, der tager mest tid eller introducerer flest fejl — typisk patching. Skriv en playbook. Kør den. Evaluer. Byg videre derfra i jeres eget tempo, uden at binde jer til et stort roadmap fra dag ét.

Playbooks fungerer desuden som levende dokumentation. Hver playbook viser præcis, hvordan et system skal se ud — og gør det muligt for en ny kollega at forstå, reproducere og fejlsøge opsætningen uden at spørge den person, der “altid har lavet det”.


Hvordan kommer man i gang i praksis?

For de fleste handler det ikke om at definere en stor strategi fra starten, men om at få de første erfaringer i drift.

Typisk giver det mening at begynde med en afgrænset opgave – som patching eller konfiguration – og derfra bygge videre. Det giver både hurtig effekt og et bedre grundlag for at vurdere, hvor automatisering giver mest værdi.

I praksis ser vi ofte, at det kræver:

  • at få identificeret de rigtige startpunkter
  • at få skrevet de første playbooks rigtigt fra starten
  • at sikre, at automatiseringen passer ind i eksisterende drift og værktøjer

Hvis du er nysgerrig på, hvor det giver mening at starte i jeres setup, kan det ofte afklares ret hurtigt i en uformel snak. Du er velkommen til at række ud til Mads Andersen via formularen herunder og vende jeres situation – så kan I sammen finde ud af, hvad næste skridt kunne være.

Kun så vi ved, hvem vi skriver til – ingen lister, ingen spam.
Hjælper os med at sætte dit spørgsmål i den rigtige kontekst – og det er dét.
Vi bruger den kun til at svare dig tilbage. Én gang, punktum.
Kun hvis det er nemmere at ringe dig op. Ingen skjulte salgsopkald.
Smid gerne et par stikord, så rammer vi rigtigt fra start.

Nyhed

Invitation til Red Hat Innovate Together 2026

Menu