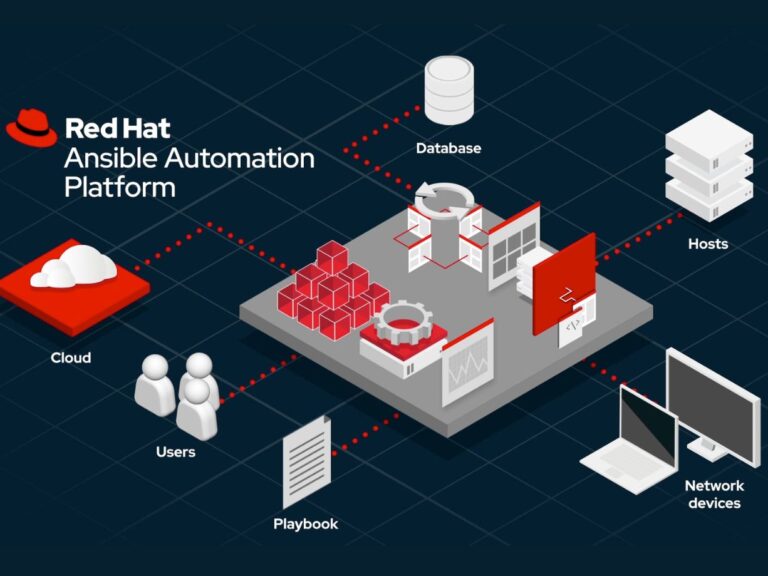
Forrester Research udnævnte i december 2024 Red Hat Ansible Automation Platform som markedsleder inden for Infrastructure Automation Platforms. Det er en ekstern validering, der burde sætte gang i en intern diskussion hos mange it-afdelinger — ikke fordi Ansible er nyt, men fordi de fleste it-afdelinger stadig løser driftsopgaver manuelt, som de kunne have automatiseret for to år siden.
Problemet er sjældent manglende vilje. Det er manglende tid, manglende overskud og en opfattelse af, at automatisering er et DevOps-projekt, der kræver et roadmap, et team og et budget. Det er det ikke. Ansible er et driftsværktøj — og det kan tages i brug fra den opgave, der stjæler mest tid i dag.
Manuel drift udfordingen
De fleste it-afdelinger har en serverpark, der patches ad hoc. Ændringer rulles ud manuelt, ét system ad gangen — og dokumentationen er enten forældet eller ikke-eksisterende. Det fungerer, indtil det ikke gør.
Konsekvenserne er veldokumenterede og konkrete:
- Nøglepersonafhængighed: Én person ved, hvordan 40 servere er konfigureret. Hvis den person er syg, på ferie eller siger op, ved ingen andre præcis, hvad der er sat op — og hvordan.
- Menneskelige fejl: Manuel konfiguration introducerer fejl. Jo flere servere, jo større sandsynlighed for, at de ikke er identisk konfigureret — og jo sværere er det at fejlsøge, når noget går galt.
- Manglende auditspor: Ingen kan dokumentere, hvornår hvad blev ændret. Det er et problem ved interne audits, et compliance-problem og en reel risiko, når der opstår hændelser.
- Patching-efterslæb: Fordi patching er tidskrævende og forbundet med nedetidsrisiko, udsættes det. Det skaber sikkerhedshuller, der vokser stille og roligt — indtil de udnyttes.
Det er ikke et problem, der løses med mere personale. Det løses med forudsigelig automatisering.
Hvad Ansible faktisk er — og hvad det ikke er
Red Hat Ansible Automation Platform er et automatiseringsværktøj til drift. Det er ikke primært et CI/CD-pipeline-tool, et DevOps-framework eller et containerorkestreringssystem — selv om det kan understøtte alle tre.
Kerneprincippet er enkelt: Playbooks beskriver, hvordan systemer skal se ud — og Ansible sørger for, at de faktisk gør det. Playbooks er skrevet i YAML, de er læsbare for både teknikere og ledere, og de fungerer samtidig som levende dokumentation over jeres infrastruktur.
Ansible er agentløst. Det kræver ingen installation af software på de systemer, der skal styres — og dermed ingen ny infrastruktur, ingen nye afhængigheder og ingen ny sikkerheds-angrebsflade. Det gør Ansible særligt egnet til eksisterende RHEL-miljøer, hvor man vil automatisere drift uden at gøre det til et projekt i sig selv.
Forrester Research’s anerkendelse i december 2024 understreger, at Ansible ikke er et nicheprojekt — det er den platform, markedet konsoliderer sig omkring, fordi den er åben, fleksibel og praktisk at integrere med eksisterende leverandørsoftware.
Tre konkrete startpunkter i jeres drift
Automatisering behøver ikke starte stort. De fleste virksomheder finder hurtigt én opgave, der giver umiddelbar effekt — og derfra bygger det sig selv.
- Automatiseret patching af RHEL-servere
Patching er den mest tidskrævende og fejlbehæftede manuelle driftsopgave i de fleste Linux-miljøer. Med Ansible defineres en patchingprocedure én gang i en playbook — og den køres derefter ens på tværs af alle servere, planlagt og verificeret. Resultatet er færre fejl, kortere vinduer og et auditspor over præcis, hvad der er patchet hvornår. - Ensartet konfiguration på tværs af serverparken
Ansible sikrer, at alle servere er konfigureret identisk — og at de forbliver det. Konfigurationsdrift, hvor servere gradvist afviger fra hinanden, er en hyppig kilde til fejl og sikkerhedsbrister. Ansible detekterer og korrigerer afvigelser automatisk. - Systemhardening og compliance-checks
Ansible understøtter automatiseret hardening af RHEL-systemer ud fra kendte compliance-rammer. Det betyder, at sikkerhedskonfiguration ikke er noget, der sættes op én gang og aldrig valideres — det er noget, der verificeres løbende og dokumenteres automatisk.
[BILLEDE: Illustration af automatiseret flow — server → playbook → drift, simpelt diagram]
Ansible starter ikke som et roadmap — det starter som én opgave
En af de hyppigste misforståelser om Ansible er, at man skal have et færdigt automatiseringslandkort, inden man begynder. Det er forkert — og det er også den tilgang, der oftest fører til, at projektet aldrig starter.
Den effektive tilgang er gradvis adoption. Start med den opgave, der tager mest tid eller introducerer flest fejl — typisk patching. Skriv en playbook. Kør den. Evaluer. Byg videre derfra i jeres eget tempo, uden at binde jer til et stort roadmap fra dag ét.
Playbooks fungerer desuden som levende dokumentation. Hver playbook viser præcis, hvordan et system skal se ud — og gør det muligt for en ny kollega at forstå, reproducere og fejlsøge opsætningen uden at spørge den person, der “altid har lavet det”.
Hvordan kommer man i gang i praksis?
For de fleste handler det ikke om at definere en stor strategi fra starten, men om at få de første erfaringer i drift.
Typisk giver det mening at begynde med en afgrænset opgave – som patching eller konfiguration – og derfra bygge videre. Det giver både hurtig effekt og et bedre grundlag for at vurdere, hvor automatisering giver mest værdi.
I praksis ser vi ofte, at det kræver:
- at få identificeret de rigtige startpunkter
- at få skrevet de første playbooks rigtigt fra starten
- at sikre, at automatiseringen passer ind i eksisterende drift og værktøjer
Hvis du er nysgerrig på, hvor det giver mening at starte i jeres setup, kan det ofte afklares ret hurtigt i en uformel snak. Du er velkommen til at række ud til Mads Andersen via formularen herunder og vende jeres situation – så kan I sammen finde ud af, hvad næste skridt kunne være.